【技術文】為香港的演出場地建立座位表:hkperf-venue-seats 的資料設計
這篇文章分享的,是我最近做的一個項目:hkperf-venue-seats。它把香港主要表演場地的座位,整理成公開、有結構、可核對的座位表(seat list)。
幾年前,我寫過一篇 Excel 文章:如何為音樂廳的座號排序?當時的問題是,「A1、A2、A10、B1」這樣的座號,用字串排序會亂成一遍。
當時我以為,那是座號最麻煩的地方。後來才發現,我錯了。
排序只是第一關。真正麻煩的,是座號本身並不老實:有些座位沒有號碼,有些排沒有 I,有些場地的座位 1 在左邊,有些在右邊,有些場地是圓形的,根本沒有「左右」。
這篇文章分享的,是我最近做的一個項目:hkperf-venue-seats。它把康樂及文化事務署(康文署)轄下表演場地的座位,整理成公開、有結構、可核對的座位表(seat list)。談得興高采烈,是因為我給自己定下三個前設:
- 只發佈事實,不發佈圖紙:每個座位的排、號、標記,而不是座位的畫面;
- 每一份座位表都要自己與自己驗證得來:數目對不上,就不准出街;
- 資料來源只有康文署公開的座位圖,不碰任何票務資料。
項目由 2026 年 9 月 26 日開始,到 10 月 4 日,九日內有 54 次 commit,目前共 43 份座位表。
為什麼是「座位表」,不是「座位圖」
先交代用詞,因為這在項目中很重要。我在項目裏寫了一份 GLOSSARY.md,因為一個詞用得不準,後面整個設計都會歪:
- Seat plan(座位圖):康文署印出來的文件;
- Seat list(座位表):發佈的紀錄;
- Seat map(座位地圖):畫出來的圖。
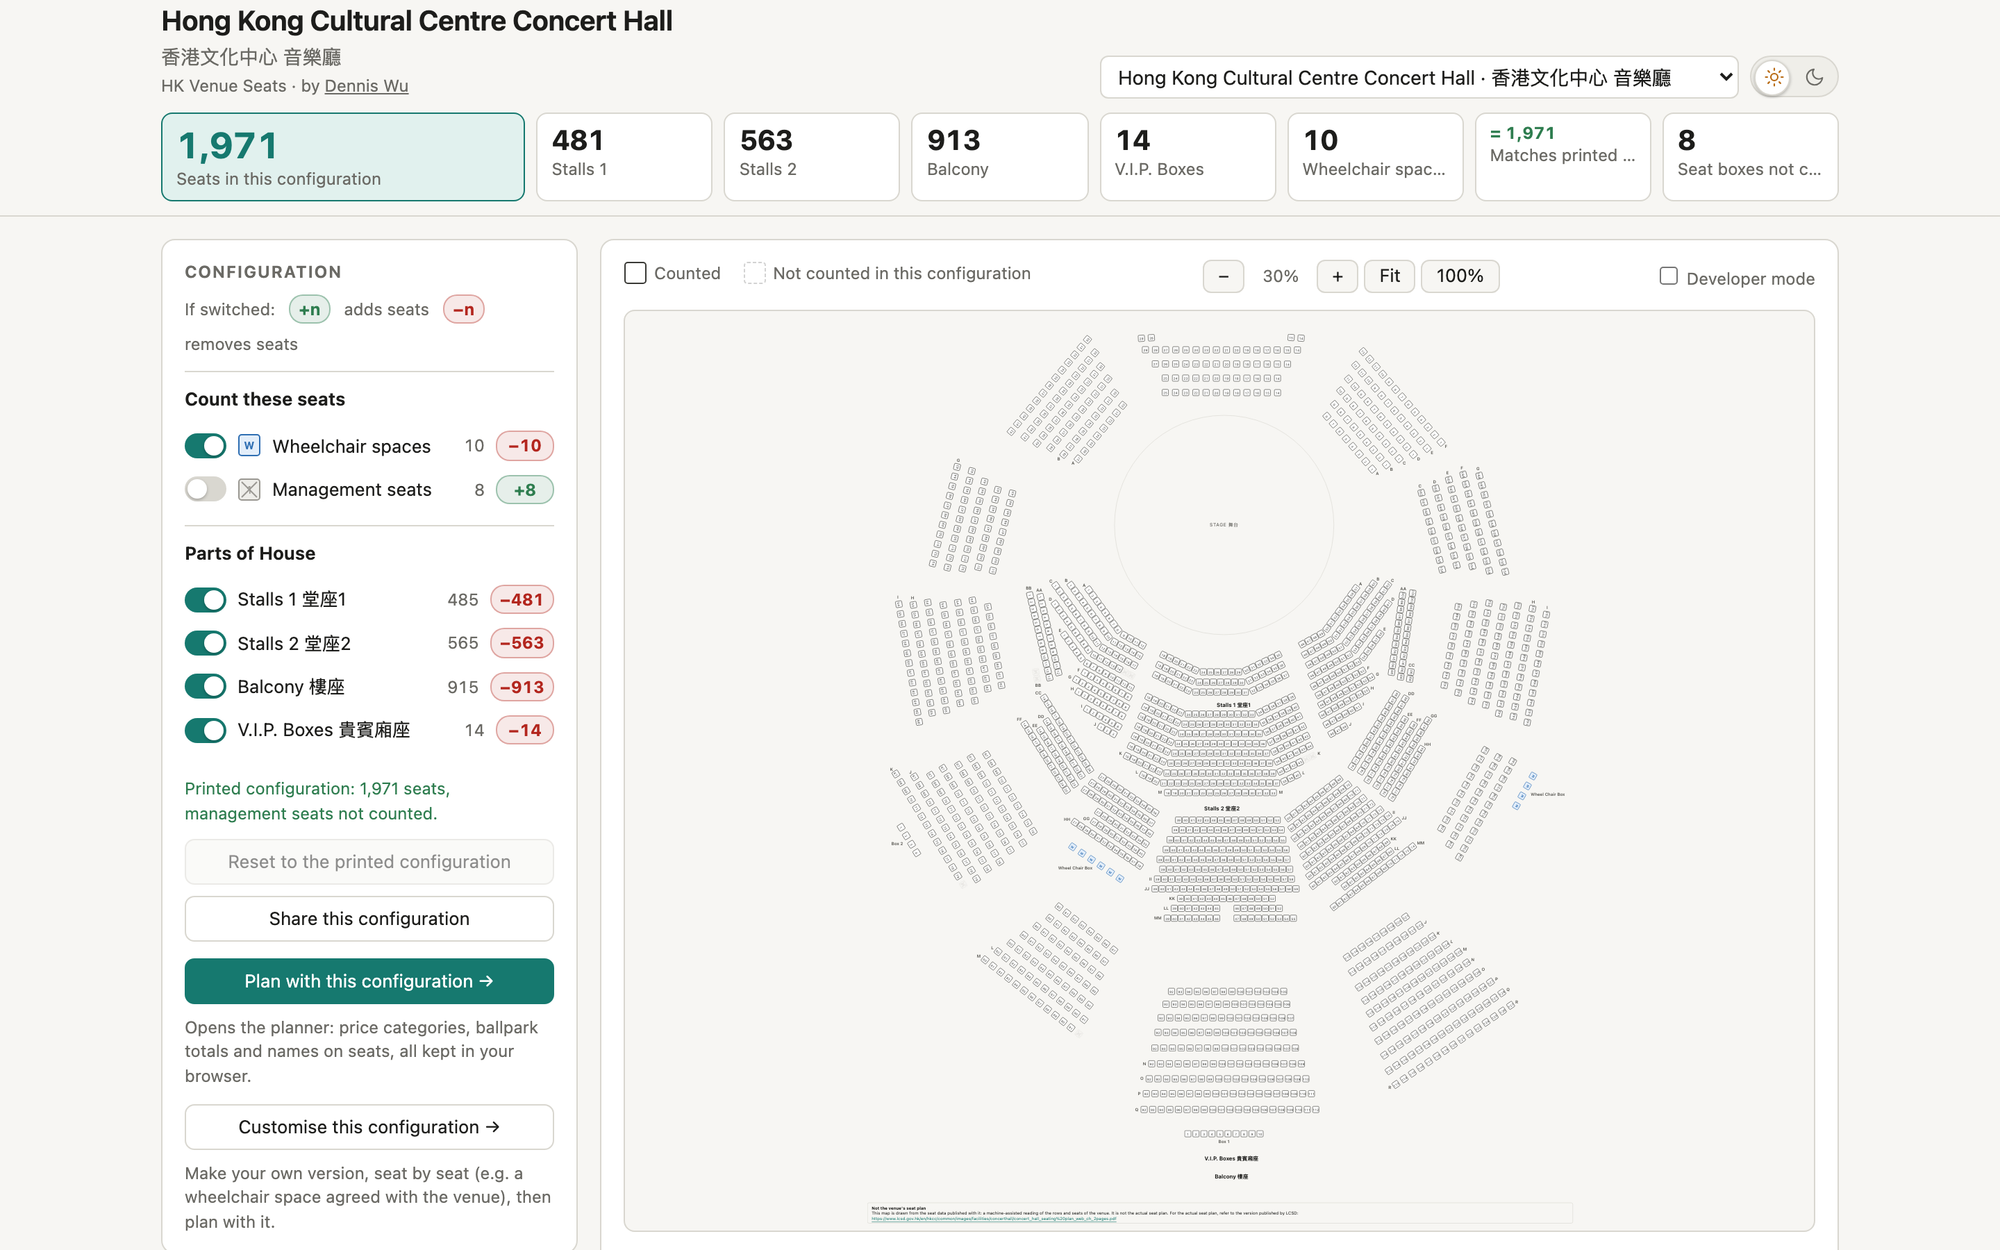
我發佈的是第二樣。每個座位沒有座標,沒有底圖,也不附上任何一張康文署的圖。有的只是:這個場地有哪些部份(part of house),每部份有哪些排,每排有哪些座位,哪些是輪椅位,哪些是管理席。
這個取捨,一部份是版權考慮(見下文),另一部份是因為我相信:事實比圖紙耐用。圖可以重新畫,但資料一旦錯了,所有用它的人都會錯。
整體配置
先描述各個組件:
- Seat lists:每個場地一份 JSON,加一份 CSV。例如
ktt-aud.json是葵青劇院演藝廳。另有data/index.json列出所有場地。 - Viewer:畫出座位表,讓你按配置(例如啟用樂池)查看座位數目。純 HTML / JS,沒有 build step。
- Planner:定價與座位規劃,可分價區、估算總收入、封鎖或預留座位。
- Customiser:讓使用者在公開座位表上加自己的修改,而不是複製一份。
draft_rows.py:由座位圖草擬每排資料的 Python 工具,用pymupdf、numpy,並在 macOS 上用 Apple Vision 做 OCR。- Reviewer:核對座號與構圖的內部頁面。這個只存在於 repo 裏,網站上沒有,下文會細談。
Viewer 與 Planner 用的,就是公開的那份座位表。沒有私有的後門資料。
Schema 的設計邏輯
Schema 目前是 hkperf-venue-seats/seatlist@0.5。它不是一次設計好的,而是由九日內不斷遇到新場地逼出來的。回頭看,背後有幾條邏輯。
一、層級跟着現實走:部份 → 排 → 塊 → 座位
zones            部份(例如 Stalls、Balcony)
 └ rows          排
    └ blocks     塊(被走道分開的一段)
       └ seats   座位 ID,由座位 1 那一邊起,按物理次序
「塊」是這個結構的關鍵。同一排被走道切開,各段的號碼未必連續,例如 1–6,然後 19–24。如果把整排當成一個陣列,走道就沒有地方放。
座位的次序,是物理次序,而不是數字次序。號碼只是標籤。
二、座位 ID 是字串
在 Excel 時代,我把座號當成「一個字母加一個數字」。在這個項目裏,座位 ID 是字串:"1",或者 "W1"、"X1"。因為輪椅位與管理席,座位圖上常常只印 W 或 X,沒有號碼。
要指認一個座位,需要的是 {部份, 排, 座位 ID},而不是 {排, 號}。因為同一個字母,可以在不同樓層重複出現。我在 glossary 裏,甚至禁止自己用「seat number」這個詞,因為它暗示每個座位都有號碼。
故事教訓:如果你的資料模型,無法表達「這個座位沒有號碼」,它就會逼你在資料裏撒謊。
三、「印出來的」與「推算出來的」要分開
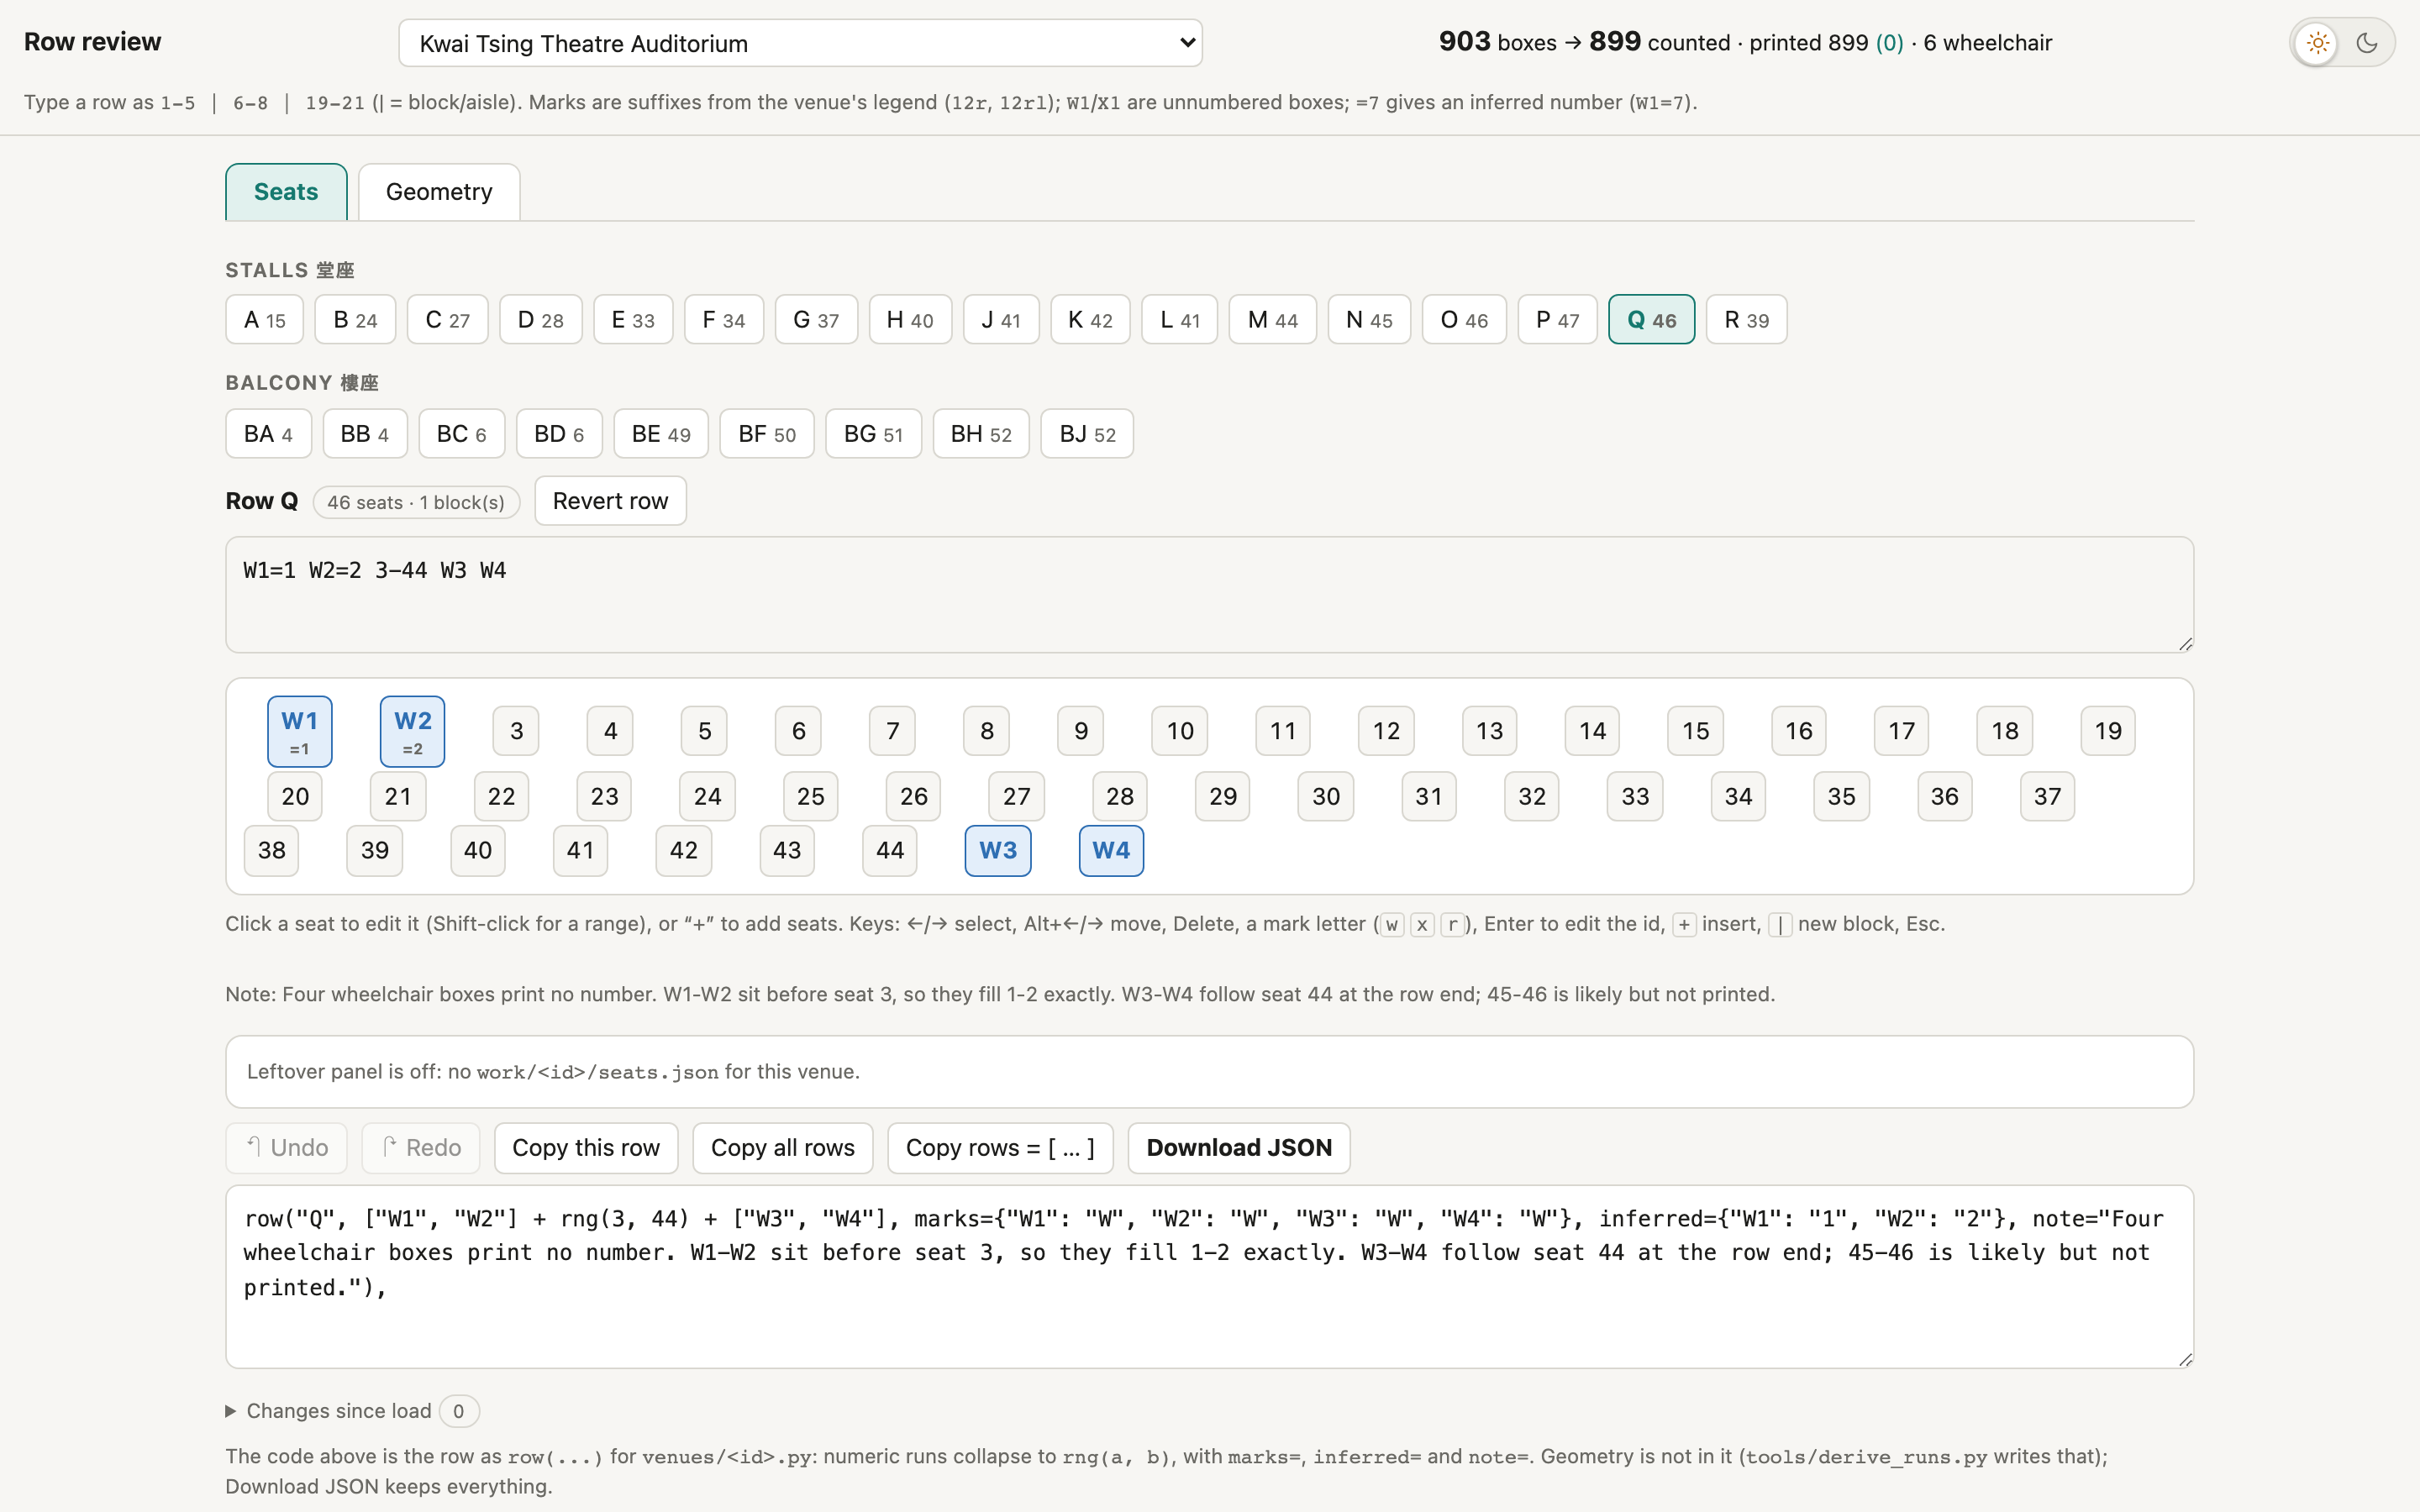
這是我最堅持的一條。以葵青劇院演藝廳的 Q 排為例(節錄):
{
  "row": "Q",
  "blocks": [{ "seats": ["W1", "W2", "3", "4", "…", "44", "W3", "W4"] }],
  "marks": { "W1": "W", "W2": "W", "W3": "W", "W4": "W" },
  "inferred_numbers": { "W1": "1", "W2": "2" },
  "note": "Four wheelchair boxes print no number. W1-W2 sit before seat 3, so they fill 1-2 exactly. W3-W4 follow seat 44 at the row end; 45-46 is likely but not printed."
}
W1、W2 的號碼是推算的,所以放在 inferred_numbers;W3、W4「很可能」是 45、46,但圖上沒有印,所以不推算,只在 note 寫明。CSV 裏還有一欄 number_basis,值是 printed 或 inferred。
推算的規則只有一條:兩邊的印刷號碼之間,空缺剛好吻合才推算。
6 · X X · 9 → X 是 7、8
同一個思路,也用在樂池:rows_basis: "inferred",連同推算過程與原文引句,一併寫進資料。(見下文「樂池謎題」。)
四、冗餘是故意的
每份座位表都帶着 printed_totals(圖上印的總數)與 count_check(我數出來的)。同一個數字存兩次,目的是讓機器可以對數。
五、來源要可追溯
source 記錄圖紙的發佈機構、網址、檔案名、SHA-256 與版本;location 的地址與座標,各自帶有來源;orchestra_pits 附有原文引句與擷取日期。
六、Schema 只加、不改:向後相容
版本歷史是這樣的:
- 0.3:加入
banks,記錄觀眾坐在舞台的哪一邊(前、左、右); - 0.4:加入
back,記錄對面的觀眾(橫向或環繞舞台); - 0.5:加入
arc,用方位角與距離描述圓形場地。
每一次,舊檔案都不用改,讀法也一樣。更重要的是,arc 只是附加的一層:一個不認識 arrangement 的程式,仍然可以讀到每一個座位、每一項核對。
這個原則是:幾何只是畫圖用的,事實層不能依賴它。
七、每個場地的「圖例」自己帶着
marks 是每個場地自己的圖例:W 輪椅、X 管理席、R 視線受阻、L 腿部空間有限。每一排的 marks 是「座位 ID → 標記字母」,所以標記是座位的屬性,不是座位 ID 的一部份。
沒有號碼的座位,以及更多怪事
輪椅位與管理席沒有號碼,只是其中一個問題。以下是我在不同場地遇到的:
- 座號分區固定。文化中心大劇院的樓座,分塊的號碼段是 1–、12–、34–。號碼在塊與塊之間會跳。
- 沒有 1 至 7 號。東九文化中心 The Turns 的端式舞台配置,A 至 J 九排(沒有 I),由左至右是 8 至 27。所有排都沒有座位 1–7。
- 缺了某些字母。葵青劇院演藝廳堂座沒有 I 排,樓座沒有 BI。但沙田與屯門大會堂,卻有 I 排。大會堂劇院則沒有 I、O、U。
- 雙字母排。上環文娛中心有 AA、BB,在 A 之前。
- 座位 1 在哪一邊?每份座位表都有
seat_1_side。葵青、大埔演藝廳是右邊,多數場地是左邊。 - 只有輪椅位的排。元朗劇院的 Y 排,只有 Y1、Y2、Y34、Y35 四個輪椅位。
- 側牆的包廂。葵青演藝廳的 BA–BD,每格座位面向舞台,但編號是從右邊數起。
這些都不是「錯」,而是每個場地各有各的歷史。資料模型的任務,不是把它們抹平,而是記錄下來。
自我核對:數目對不上,就不准 build
每份座位圖,都印有座位總數。 finish() 函數,在寫出 JSON 之前會檢查:
圖上畫出的格數 − 管理席 = 圖上印的總數
每一個部份都要通過,各部份加起來也要等於總數。差一個,build 就失敗。
以葵青演藝廳堂座為例:629 格,其中 4 個管理席,4 個輪椅位。629 − 4 = 625,與圖上印的 625 一致。輪椅位、視線受阻、腿部空間有限的座位都算在總數之內,管理席則不算。這是康文署算法的「閱讀」,而每一個部份都吻合,所以我才有信心。
當然,也有例外。高山劇場的六個輪椅位,是圖上另外加到總數的;城市會堂音樂廳的 12 個走廊座位,畫了但沒有計算。這些例外,都要明確寫在資料裏(count_excludes),而不是悄悄修正。
樂池謎題
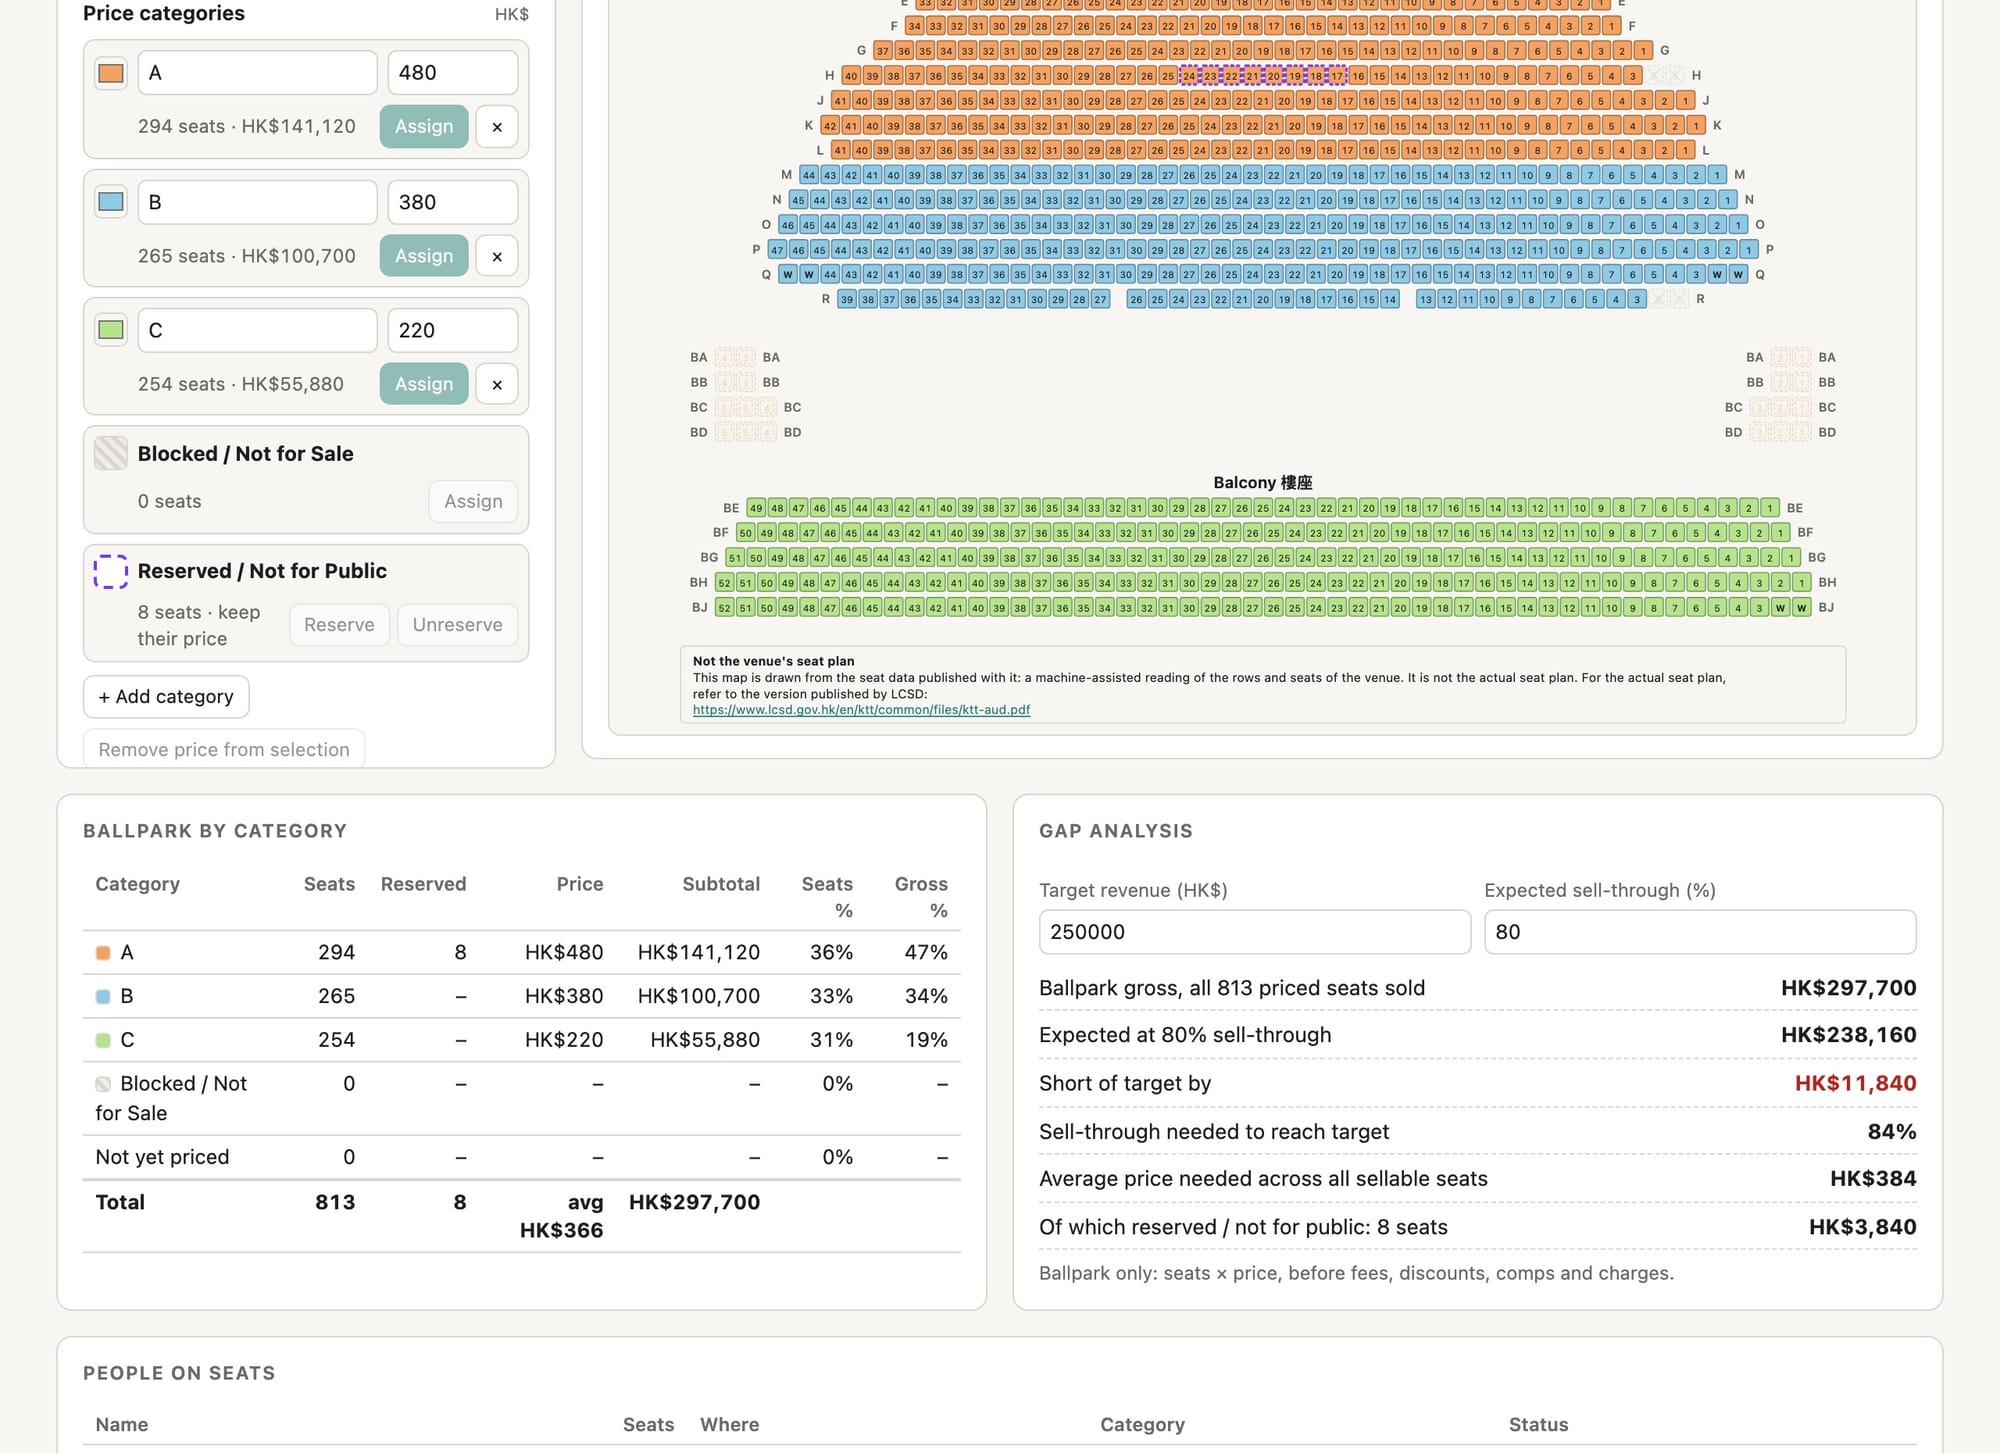
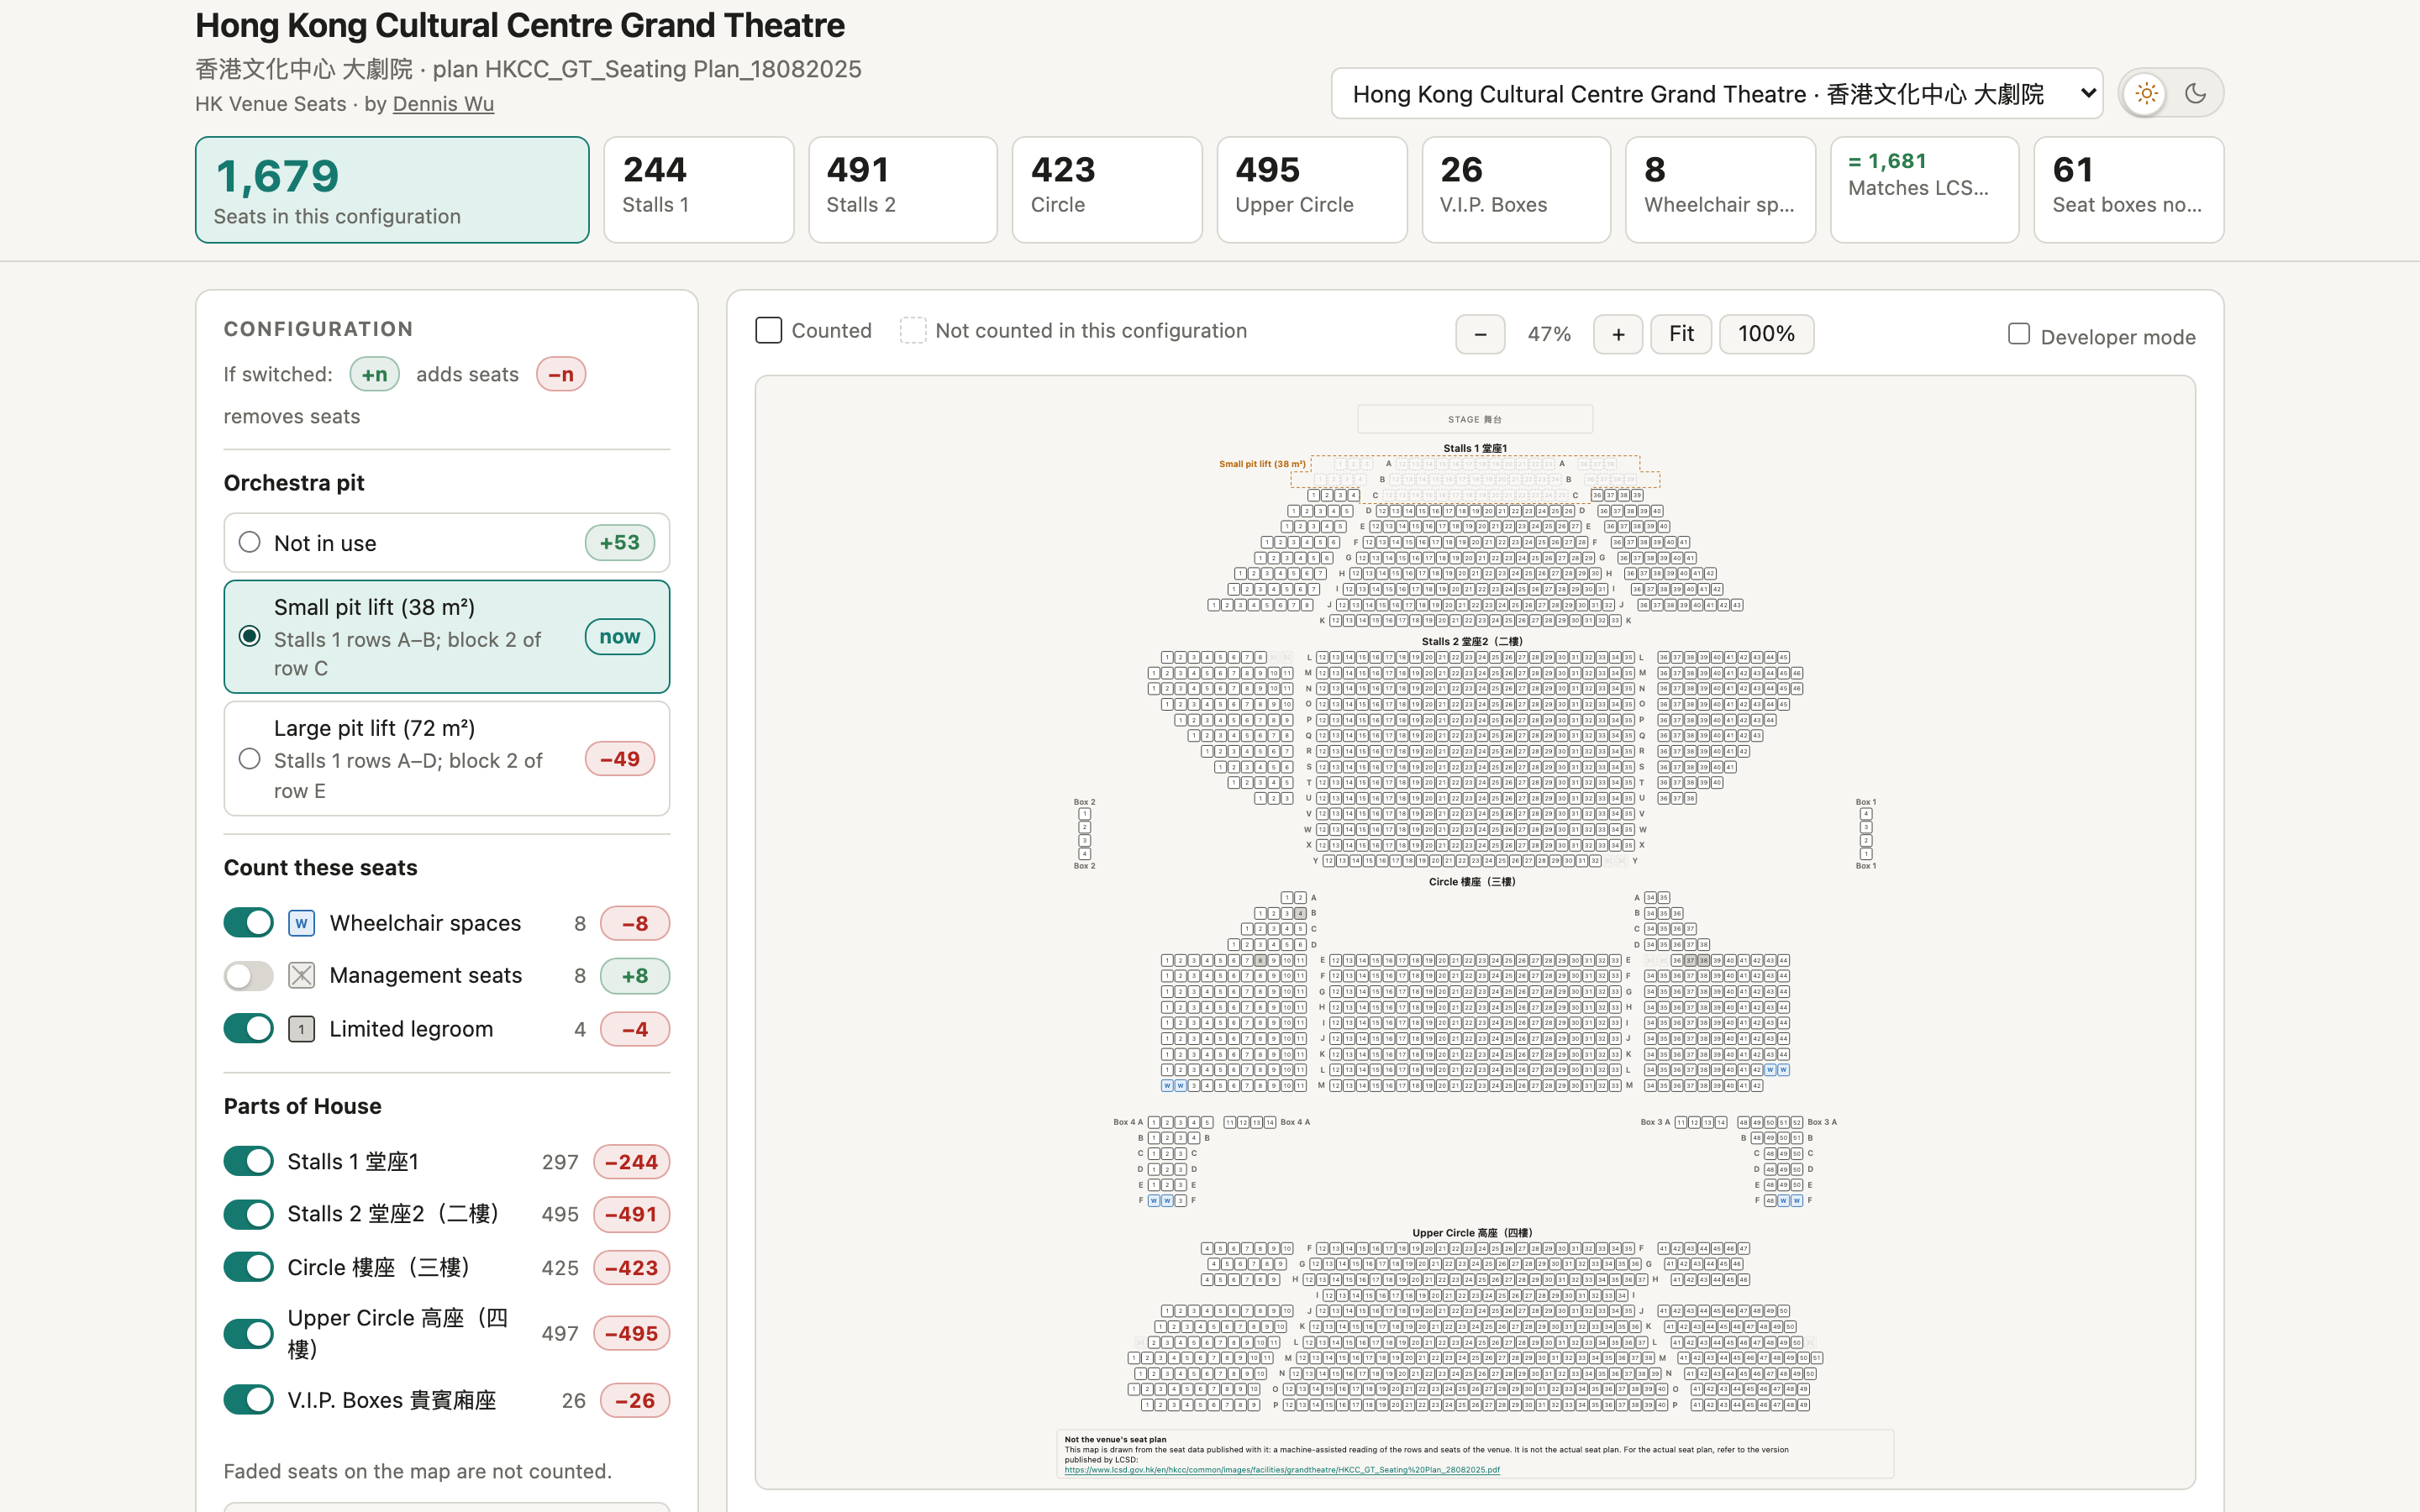
康文署的資料,常常只寫「啟用樂池後有 833 個座位」,而不說哪幾排被拆掉。
葵青演藝廳是 899 個座位。899 − 833 = 66。逐個試:
- 只拆 A 排:15 個;
- 拆 A 至 B:39 個;
- 拆 A 至 C:15 + 24 + 27 = 66;
- 拆 A 至 D:94 個。
只有 A 至 C 恰好是 66。所以座位表裏寫的是拆 A、B、C 三排,並標明 rows_basis: "inferred",附上推算過程。
對主辦者而言,樂池有沒有啟用,直接影響賣票的數量。文化中心大劇院是 1,734 個座位;用小升降台的話,剩 1,681;用大的,剩 1,632。
Reviewer:核對座號與構圖
這個部份,是整個項目裏我最倚賴、但你卻看不到的東西。
tools/review.html 是一個只存在於 repo 的內部頁面,沒有發佈到網站,因為它可以把座位圖畫在底下作對照。你要自己在本機跑一個 server 才能打開。
工作流程是這樣的:
draft_rows.py掃描座位圖,找出每一格座位,讀取號碼與標記,草擬每一排;- 我把檢查過的事實,手寫進
venues/<id>.py; venues/common.py核對總數,寫出 JSON;- 在 Reviewer 逐排、逐塊覆核。
Reviewer 有兩個分頁。
Seats 分頁:核對座號。 每一排都有兩種表達方式:
- 一行文字,例如
1-5 | W1=6 7r 8rl。|是塊的邊界,小寫字母是標記,W1是沒有號碼的格,=n是推算號碼; - 一排座位小方塊(chip),可以用鍵盤選取、加標記、移動、新增、拆開、刪除。
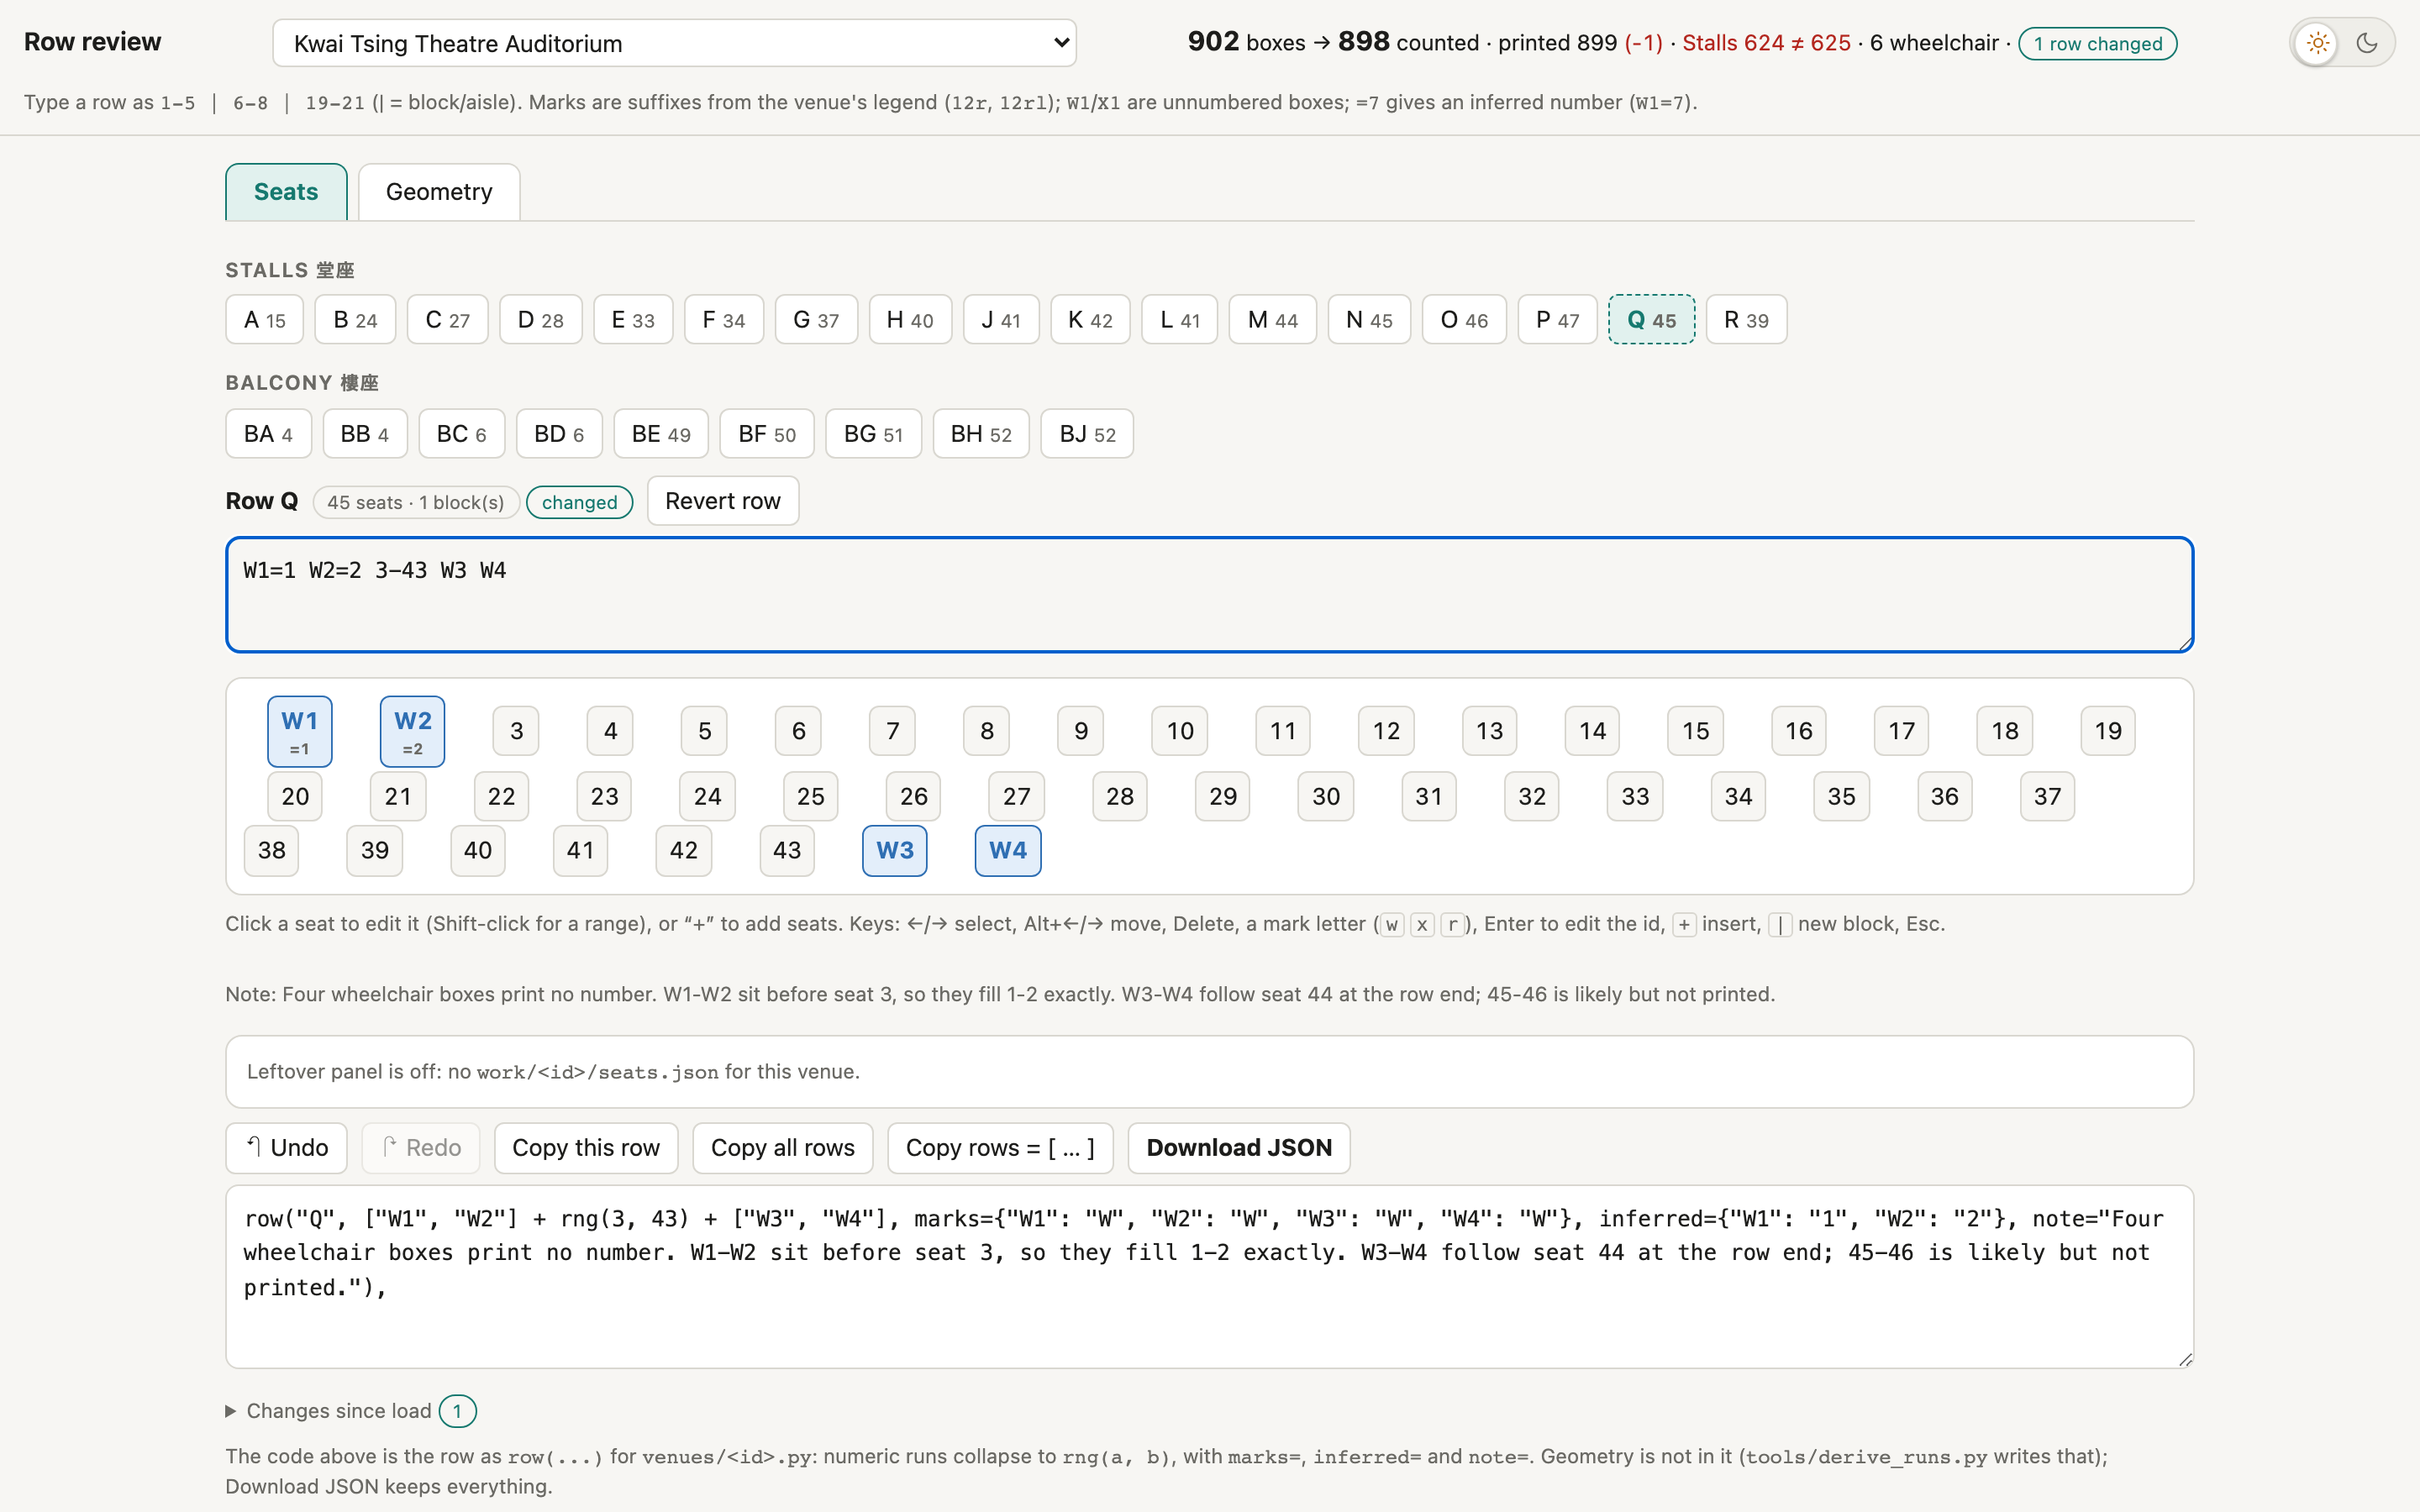
這個頁面最有用的,是頁首會即時用與 build 完全相同的規則,核對每個部份的總數。我在修改一排時,數字當場就紅或綠,不需要等 build。
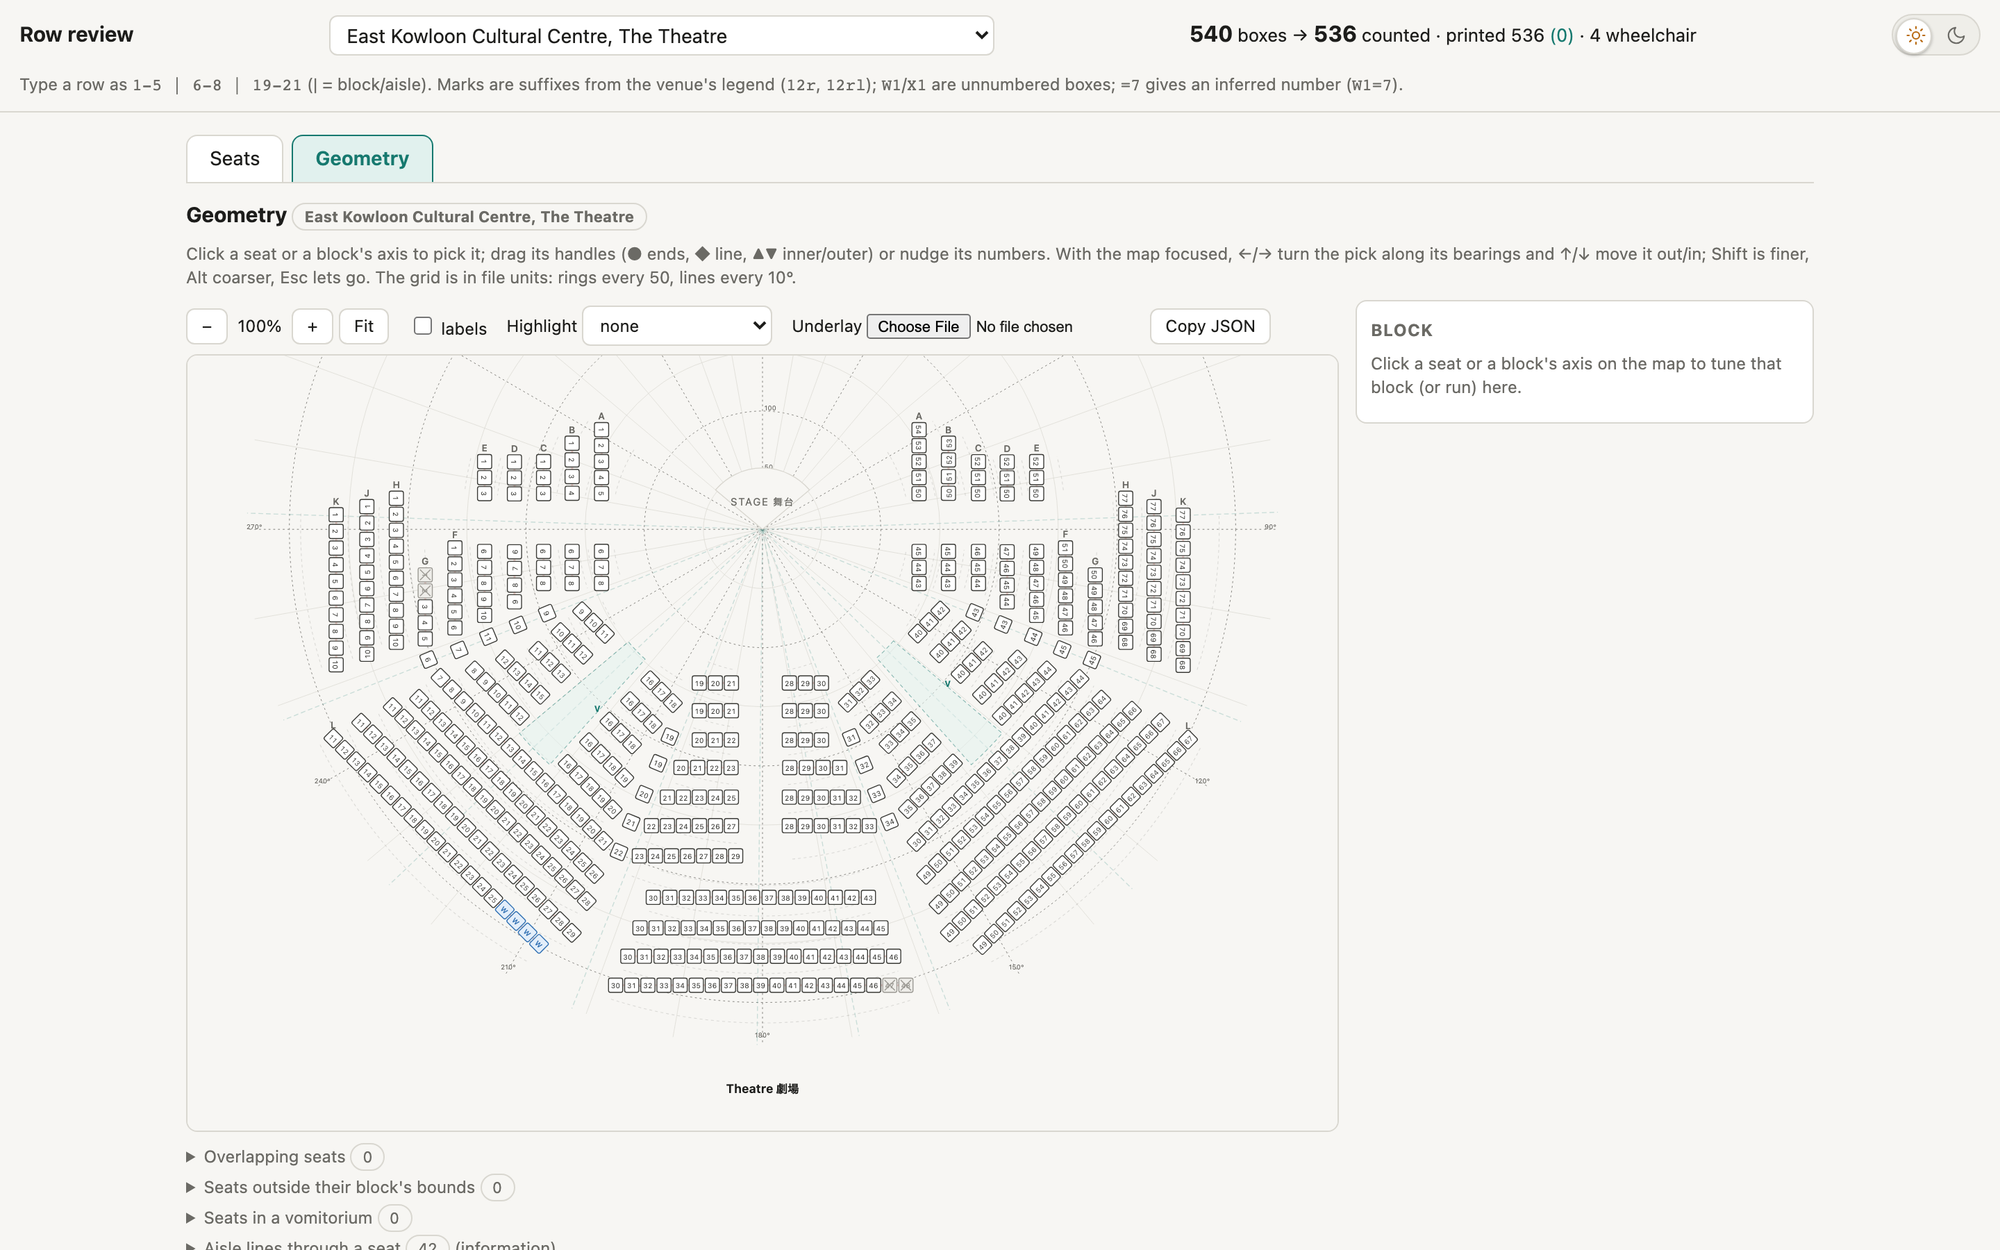
Geometry 分頁:核對構圖。 這是為圓形場地而設的。點選一個座位或一條軸線,就選中它所屬的塊(或直線段),然後用箭頭鍵微調,或者拖曳。地圖會即時標出:
- 重疊的座位;
- 超出所屬塊範圍的座位;
- 落在 vomitorium(觀眾入口)之內的座位。
你還可以把座位圖放在地圖下面當底圖,直接對照。這個底圖只存在我自己的硬碟,不會寫進任何檔案。
其他功能:Undo / Redo 同時涵蓋兩個分頁;「Changes since load」會列出與原檔案的每一個差異。
故事教訓一:Download JSON 的輸出,格式與 common.py 一模一樣,所以 git diff 只會顯示我真正改過的地方。故事教訓二(踩過的坑):在 Reviewer 改了排,如果沒有同步改venues/<id>.py,下次 build 就會把改動沖掉。所以 Reviewer 有一個「Copy rows = [ … ]」按鈕,直接吐出row(...)的程式碼。而圓形場地的塊幾何,不在venues/<id>.py裏,是由derive_runs.py從座位圖量度而來。手動調整過的幾何,會被重新 build 覆蓋。後來文化中心音樂廳要手調,我就把調整另存成hkcc-ch.geometry.json,每一塊用first_seat做保險:萬一那一塊移了位,工具會發現。
圓形劇場:最難的部份
以上的場地,都是「排」與「塊」,大致可以用 bank 去描述:前、後、左、右。直到我遇到東九文化中心的劇院,和文化中心音樂廳。
東九劇院是圓形的,座位圍着舞台,排由 310° 逆時針開到約 50°。這令我新增了 schema 0.5,用方位角與距離描述每一塊座位:
- 每塊記錄一個角度(正上方起順時針)與離中心的距離;
- 座位在每條直線上均勻分佈;
- 彎曲的塊,拆成幾段直線(
runs)。
這個階段,Reviewer 的 Geometry 分頁幫了大忙。我用了幾天,才調到沒有任何座位重疊。
而文化中心音樂廳更麻煩:座位圖沒有文字層,數字是畫出來的筆劃,OCR 派不上用場。我寫了一個工具,用路徑指令的特徵去辨識數字,例如 "ccccllllll" 就是 1。
故事教訓:當圖紙「看起來是字」,但其實是形狀,OCR 以外,還有一條路:認形狀。
一個設計決定:Customiser 為什麼不是複製
使用者常常想改一下座位表,例如拆掉某幾個座位,因為他們的演出有特別的舞台。最簡單的做法,是讓他們複製一份。但我選擇了另一條路:記錄修改,而不是複製資料。
每個修改指向一個座位的 {部份, 排, 座位 ID},而不是「第幾塊的第幾個」。原因是:公開的座位表會不斷修正。複製一份,就會永遠停留在舊資料。用位置去指認,當我日後把一個塊拆開,修改就會悄悄移到錯的座位上。
所以,修改附有原座位表的 SHA-256。座位表更新了,它不會拒絕你,而是提醒你「請重新檢查每個修改」;找不到的座位,會被列為「不再吻合」,而不是靜靜丟掉。
另外,Viewer 只顯示公開的資料,即使網址帶有修改。一張 Viewer 的截圖,應該永遠代表公開的座位表。
版權與取捨
康文署在座位圖上聲明版權,並要求事先取得書面授權。我的處理是:
- 圖紙不放進 repo(
sources/與work/都 git-ignore); - 只發佈事實(排、號、標記、數目);
- 每份資料都標示來源,並附上原圖的 SHA-256;
- 康文署在 9 月 26 日項目公開時已獲通知,歡迎他們要求修改、移除,或者自行託管這些資料。
我判斷這個風險「低得可以先發佈、不必先問」。但這不是法律意見。
授權方面:程式碼是 MIT;Planner、Customiser 與 Reviewer 是 PolyForm Noncommercial(任何人都可以免費使用已發佈的工具,包括商業機構);座位表是 CC BY 4.0,只涵蓋我自己整理的部份,不涉及康文署在圖紙上的權利。
它的限制
- 這些資料來自圖紙,不是實地點數。有些圖紙品質很低,例如元朗劇院的圖只有一張 JPG,是我放大後逐格目測的;
- 少部份座位號碼是推算的,已標明
inferred,但仍然有可能出錯; - Reviewer 只能核對「資料是否符合圖紙」,圖紙本身若有錯,它不會知道;
- 我一個人在做,覆核主要靠自己,所以非常歡迎大家改正:在 GitHub 提 issue 就可以,我預備了座位資料更正與場地建議兩個範本。
總結
九日、54 次 commit、43 份座位表。這個速度,不是靠畫出一張更漂亮的圖,而是做一份會自己檢查自己的資料,再配上一個讓我能快速覆核的工具。
Excel 那篇文章,教的是如何把座號排好。這篇文章想說的是,在排好之前,你要先決定「座位」是什麼。


